人怎样才敢对 AI 的结果负责
我给 AI 提了一个不大的需求。它越写越长,还自己加东西:没提到的功能、犯不着的绕法,一并写进来。它隔几步问一句“这样行不行”。我判断不过来了,手还在点确认。测试都过了,看起来能跑,就算办完了。
原来好好的功能也会坏。坏在哪一轮,坏在谁确认的那一下,说不清。
改稿、连出许多图再挑一张,也是这样。模型连跑多轮,最后由人确认。
变化的起因是模型升级了。它能独立干完的活越来越长,人干活的方式跟着变了:以前是自己做,现在是给它派活、等它交、替它确认。下面三件事,都是这么来的。
先是活变长了。
有个机构叫 METR,专门测模型能独立做完多长的活。这张表 2026 年秋天停更了。最新的模型,估出来已经能碰十几个小时的活,只是到了这个长度,表上自己也说测不准。
活做完要人看完、确认。一个人一天能认真看的就那么多。它干的活越长,留给人看的就越多。
再是确认,靠人一道道点,拦不住。
弹窗一道接一道。Anthropic 做过一个实验:把一条明显危险的命令混进弹窗里,看人能不能拦下来。结果,付费用户平时对弹窗的批准率在九成以上;真到了那条危险命令,人只拦下 13.6%,负责自动判断的程序拦下了 89%。
原因不难理解:点了几十道都没事,下一道谁还会认真看。靠人这样点,拦不住多少,点的人先累了。
还有测试,过了只说明跑得起来,做对了没有,还得看规矩。
功能测试只考一件事:跑不跑得起来。但一件活做得对不对,还有另一套标准,就是事先定好的规矩。比如:对外的接口不能改;测试和评分标准不许它碰;需求里没写的功能不许顺手加。这些规矩,功能测试测不出来。
2026 年 9 月有个研究(SWE-Gate)专门考这一套:把规矩从真实评审意见里一条条抽出来,先写明给模型,再拿规矩去考它做的活。结果,功能测试全过的 644 个修复里,34.3% 不合规矩。
评分标准也一样。它看得见、改得动,就等于考试时能改考题,作弊也能过关。
说到底,功能测试和评审规矩,是两套卷子,只考一套是不够的。
放过去的东西太多,出了事说不清是哪一下,可最后点同意的是人,责任还是他的。问题出在分工上:要什么、什么算合格,本该人来定,常常被模型顺手定了;人却耗在一道道点确认上,这本是机器更擅长的事。两边都在做对方的活。
有团队先改了做法,可以看 Anthropic 一家。
他们公布过两个数:今年 7 月,全公司最终合并的代码,约 80% 是 Claude 写的;10 月,Claude Code 团队自己的代码库里,这个比例到了约 90%。一个数是全公司的,一个数只算一个产品,都是他们自己说的。能看出来的是:代码越来越多,不是人写的。
他们怎么管?把批准按危险程度分三档。
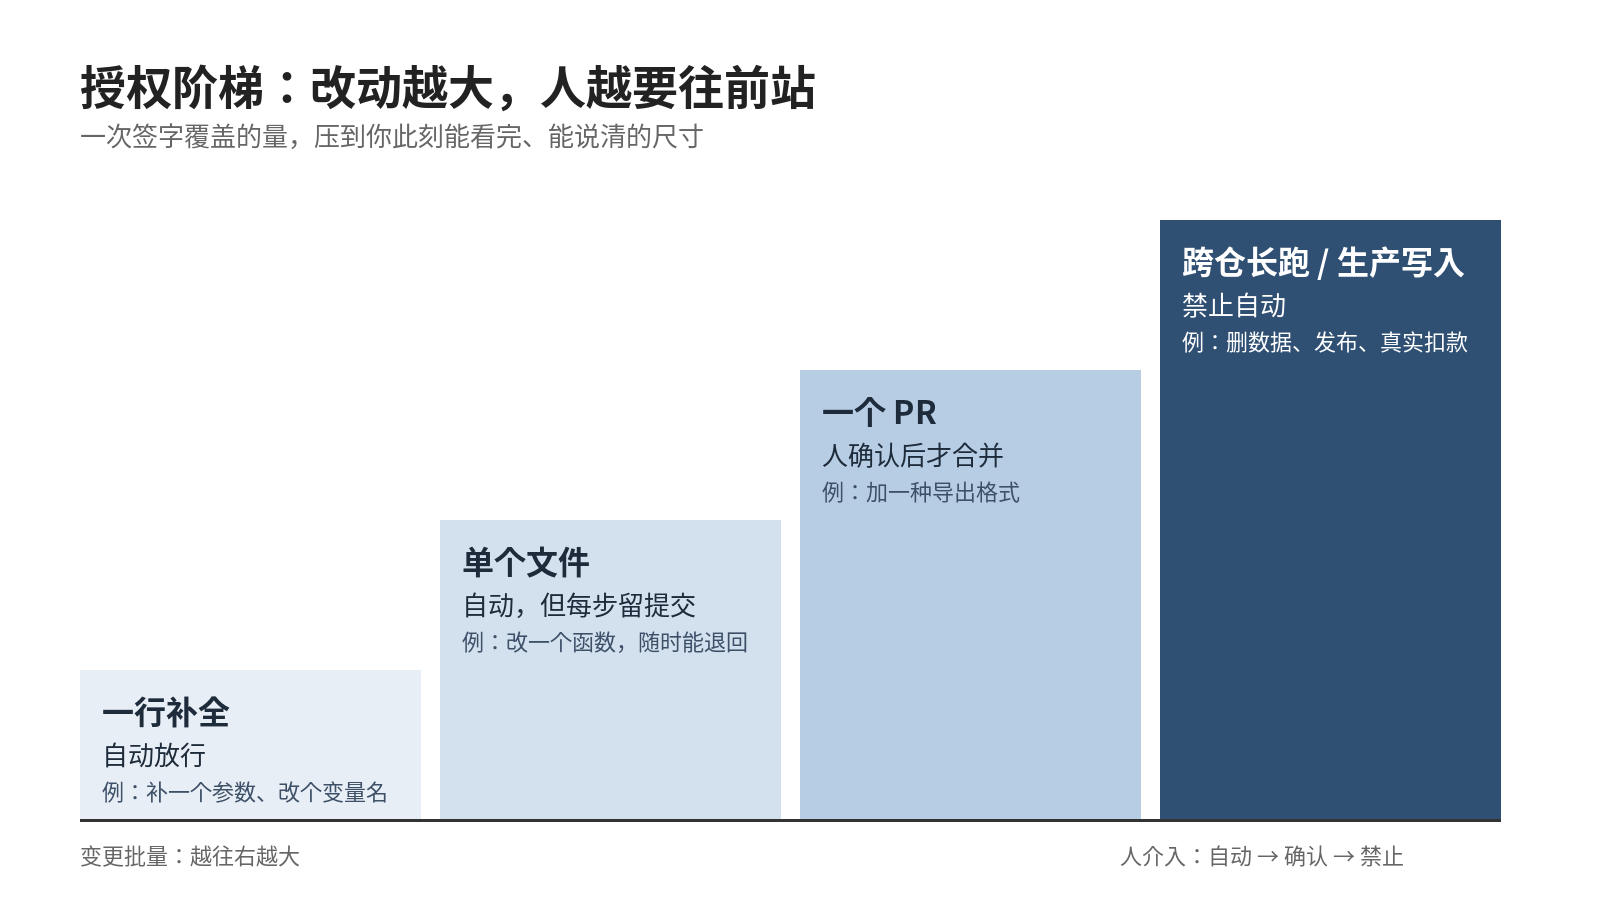
不危险的,自动检查全过,直接合并,没人批;中间的,一个人批;最危险的,两个人批。程序自己批的,不算数;这次批了,只管这一次。为什么敢这么分?他们的想法是:一个人读没读过这段代码,说明不了什么。要紧的是提前想清楚,这次改动可能出什么事,这件事应该由哪一步检查来拦。
审查的顺序也改了:代码交上来,先由程序审;程序发现问题,先让另一组模型投票,确认是真问题才贴出来;过去出过事的修改,他们攒成一套题,审代码的模型每天做一遍,看还漏不漏。效果按他们自己的统计,今年 6 月到 9 月,交上去合并的次数翻了一倍多,被撤回的比例反而降了四成多。
拆开看,他们做的就是三件事:活切小,审和写分开,确认分轻重。
整套系统个人搭不起来,但这三件事,一件一件都能自己做。
一是,一次只做一小件。
小到什么程度?不按行数算,按两条:这一件改了什么,一遍能讲清;出了问题,整件能退回去。切到这个尺寸,才审得动、验得完,它自己想加的东西,也先拦下来。这一点有实验支持:让人审埋了错的代码,改动小的,找出的错明显更多。
二是,写和审,分开两次对话。
第一层,关掉重开。写的那次结束,就关掉。另开一个新对话来审。
第二层,给的东西要挑。只有四样:最开始的需求;写明的规矩和不能碰的地方;这次改了哪些;测试结果。写的过程不给。它自己的解释也不给。它学会钻空子之后,很少在思考里提起这件事。测过的六个环境里,五个提起的比例不到 2%。也有实验测过:放到新对话里审,比在原对话里再审一遍,抓到的错更多。
第三层,新对话只查规矩。它拿规矩对着改了的地方,一条条查。SWE-Gate 漏的正是这一步。规矩写明了,执行没做到,要靠没参与写的那一遍查出来。
第四层,人看结果。人看测试记录。人看跑过的命令和结果。不只看它写的结论。
审满三轮还没过,就停下来重新想做法,别来回改。
有一个前提:需求和规矩先写成文件。不写下来,新对话不知道原来要什么。
三是,验收走两遍,确认分轻重。
自动测试先走一遍,管跑不跑得起来。人再照着最开始的需求,亲手把要紧的地方走一遍,管这是不是当初要的那个东西。日常不危险的弹窗,可以预先设成自动通过;发布、合进正式代码、扣款,不设自动,必须自己确认。注意力就这么多,得省着用。
回到开头的问题:人怎样才敢对 AI 的结果负责?
先把分工划清。负责不是把每一行都看一遍,那样既看不完,也说明不了什么。负责是三件:一次只放一小件,写和审分开,发布、合并、扣款这类动作,必须自己确认。做到这三件,心里有底,才敢签字。
来源
Anthropic auto mode https://claude.com/blog/auto-mode-default-in-claude-code
SWE-Gate https://arxiv.org/abs/2609.04167
METR reward hacking https://metr.org/blog/2025-06-05-recent-reward-hacking
Anthropic SDLC https://claude.com/blog/how-anthropic-secures-its-ai-native-software-development-lifecycle
Claude Code review https://claude.dev/blog/solving-code-review-at-anthropic/